关于看到 MiMo-V2.6 后联想到的一套 Agent 架构设计
2 min read|从 ReAct、Planner-Executor、Verifier,到可插拔 Decision Model 与 RL 训练闭环
关于看到 MiMo-V2.6 后联想到的一套 Agent 架构设计:从 ReAct、Planner-Executor、Verifier,到可插拔 Decision Model 与 RL 训练闭环,把运行时执行和训练时策略优化串成一个完整框架。
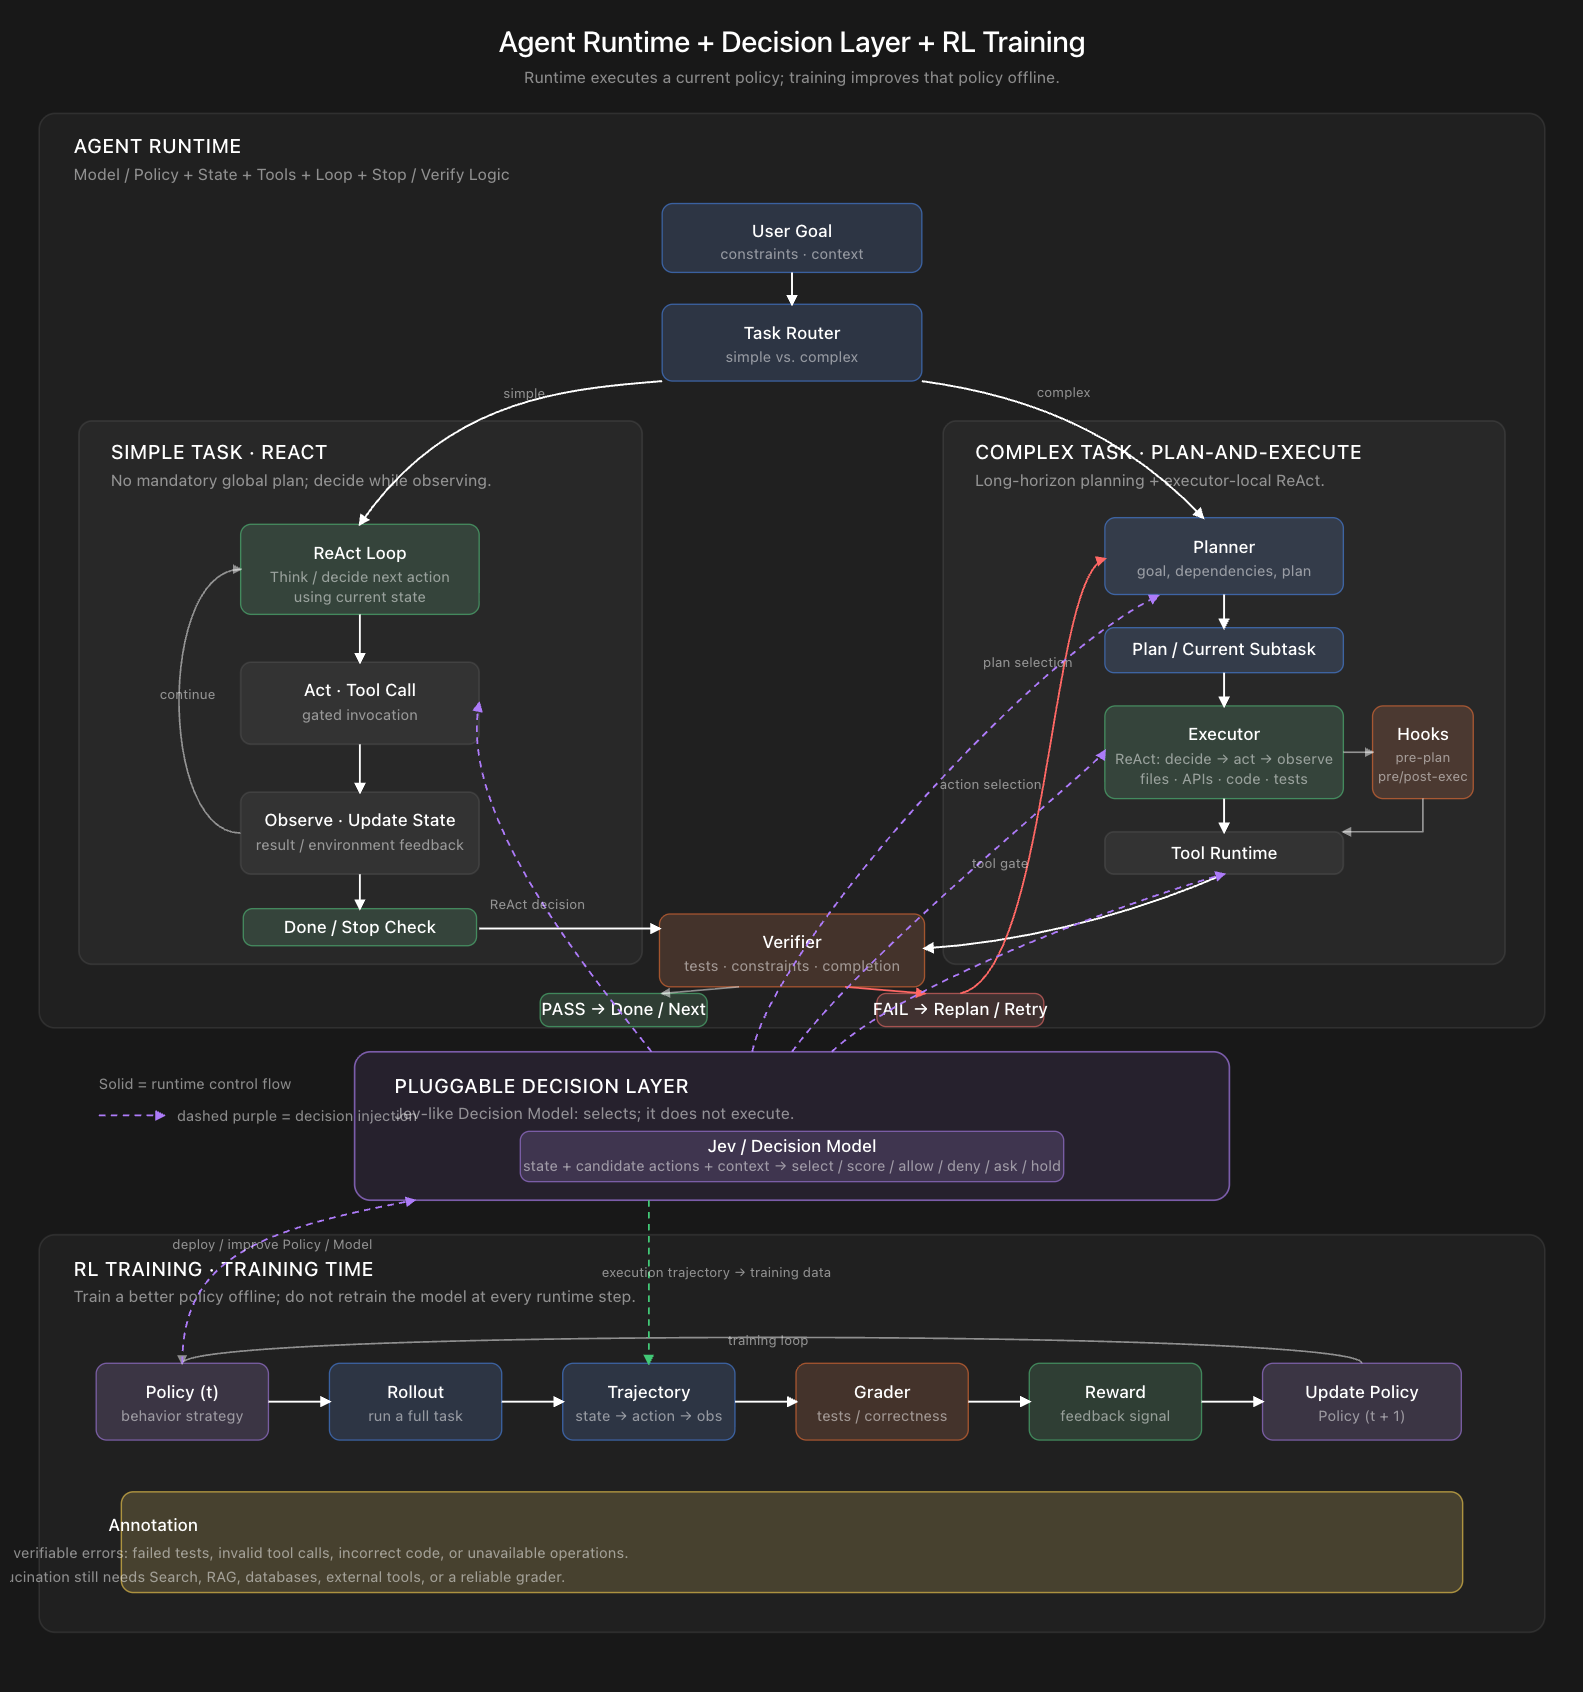
图里在讲什么
Agent Runtime(运行时执行当前策略)
User Goal→Task Router:按 simple / complex 分流- simple → ReAct 循环:Think 决定下一步 → Act 工具调用 → Observe 更新状态 → Done/Stop 判断,如此循环
- complex → Plan-and-Execute:Planner 出目标/依赖/计划 → 拆成当前子任务 → Executor 做局部 ReAct(文件·API·代码·测试)→ Tool Runtime;
Hooks挂在 pre-plan 与 pre/post-exec - 两条路径都汇入
Verifier(测试·约束·完成度):PASS → 完成或进入下一项;FAIL → 重规划 / 重试
Pluggable Decision Layer(可插拔决策层)
Jev / Decision Model:输入「状态 + 候选动作 + 上下文」,输出 选择 / 打分 / 允许 / 拒绝 / 询问 / 挂起- 关键约束:它只做选择,不执行
RL Training(训练时,离线)
Policy(t)→Rollout(跑完整任务)→Trajectory(状态→动作→观察)→Grader(测试/正确性)→Reward→Update Policy → Policy(t+1)- 原则:训练时把策略练好,不要在每个运行时步骤重训模型
线的语义:实线 = 运行时控制流;淡紫虚线 = 决策注入;绿色虚线 = 执行轨迹 → 训练数据。
注释:可验证的错误是测试失败、非法工具调用、错误代码、不可用操作;幻觉问题仍需 Search、RAG、数据库、外部工具或一个可靠的 grader。